
01 · 第一次调用模型
Stage Hello LLM · v01-model
上一章咱们把地基打牢了:pnpm dev 能跑、环境变量能读、密钥不进仓库。但说句大实话——那时候连一个字节都没发给模型,OPENAI_API_KEY 只是被读进来,又默默躺回去了。
这一章咱们干点真格的事:发第一个真实的模型请求,亲眼看看 Input → Model → Output 这条最原始的链路长什么样。而且这一章从一开始就按「OpenAI 接口风格」来做——也就是不仅能接 OpenAI 自家的模型,DeepSeek、通义千问、Moonshot、Ollama 本地模型这类同样实现 OpenAI 兼容接口的服务商,换一行配置就能接。
一、上一版存在什么问题?
回顾一下 00 章结束时 src/index.ts 做了什么:
const apiKey = process.env.OPENAI_API_KEY;
if (apiKey) {
  console.log("  OPENAI_API_KEY  已配置");
} else {
  console.warn("  OPENAI_API_KEY  未配置(复制 .env.example 为 .env 后填入)");
}
发现问题了吗?Key 校验通过后,程序就没有然后了。它证明了「环境能读 Key」,但 Key 到底是干嘛的、模型在哪、怎么把一句话送进去再把答案拿出来——这些都是空白。
换句话说:上一版只有「管道」,没有「水」。
二、本篇解决什么问题?
完成第一次真实模型调用,打通整条链路:
- 引入官方 SDK(
openai),不再自己手搓 HTTP; - 把用户的一句话(Input)发给模型;
- 模型返回一段文本(Output),程序把它打印出来;
- 顺带把耗时、token 用量这些「可观察」的信息也打出来;
- 让 Endpoint / 模型名都可配置,从此可以自由切换各种 OpenAI 兼容服务商。
这一章的「抽象」就是:不抽象。直接裸调 SDK,先看清模型到底长什么样,下一章再谈消息结构,后面才轮到 Provider 抽象。
三、先看最终效果
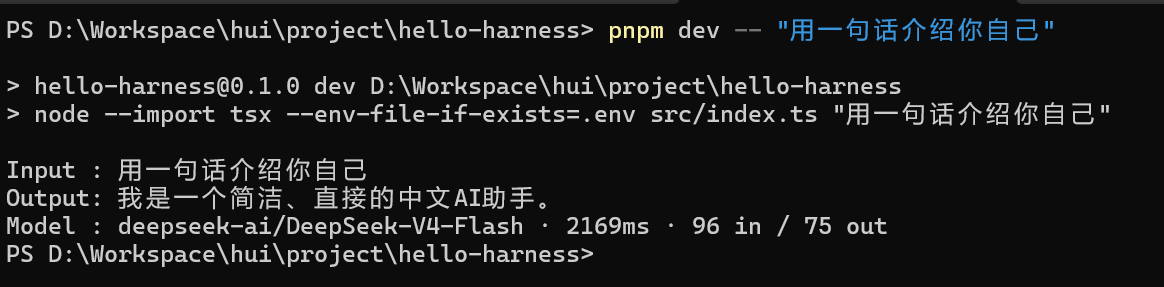
PS D:\Workspace\hui\project\hello-harness> pnpm dev -- "用一句话介绍你自己"

> hello-harness@0.1.0 dev D:\Workspace\hui\project\hello-harness
> node --import tsx --env-file-if-exists=.env src/index.ts "用一句话介绍你自己"

Input : 用一句话介绍你自己
Output: 我是一个简洁、直接的中文AI助手。
Model : deepseek-ai/DeepSeek-V4-Flash · 2169ms · 96 in / 75 out
三行输出,正好对应本章标题的三段:
| 打印 | 对应 | 含义 |
|---|---|---|
Input : | Input | 用户说了什么 |
Output: | Output | 模型回答了什么 |
Model : | Model | 用的哪个模型、花了多久、烧了多少 token |
把 .env 里的端点换成 DeepSeek、通义或本地 Ollama,同一份代码原样跑:
# .env 里配置成 DeepSeek
OPENAI_BASE_URL=https://api.deepseek.com/v1
OPENAI_API_KEY=sk-你的DeepSeek密钥
OPENAI_MODEL=deepseek-chatOutput: 你好!我是 AI 助手,很高兴为你服务。
Model : deepseek-chat · 640ms · 14 in / 22 out四、架构变化
代码没有引入任何新目录,变化的只有两处:
hello-harness/
├── src/
│   └── index.ts        # 从「环境检查」升级为「一次真实调用」
├── .env.example        # 新增 OPENAI_BASE_URL / OPENAI_MODEL 可选项
├── package.json        # 新增 dependencies: openai
└── ...
package.json 里多了一个运行时依赖(注意是 dependencies 不是 devDependencies,因为模型调用是程序本体,不是开发工具):
"dependencies": {
  "openai": "^7.4.0"
}
安装方式也顺便演示了 pnpm 的正确姿势:
pnpm add openai五、核心抽象
本章的「核心抽象」就是下面这条线,它简单到容易让人忽略,但它是一切的起点:
Input → Model → Output用 OpenAI 官方 SDK 实现,也就是一次 chat.completions.create:
const completion = await client.chat.completions.create({
  model,    // 用哪个模型
  messages: [
    { role: "system", content: "你是一个简洁、直接的中文助手。" },
    { role: "user",   content: input },
  ],
});
// completion.choices[0].message.content 就是 Output
三个值得记住的点:
- 为什么用 Chat Completions 而不是 Responses:
/v1/responses是 OpenAI 新接口,OpenAI 兼容生态的绝大多数服务商(DeepSeek、通义、本地 vLLM/Ollama……)只实现更通用的/v1/chat/completions。要「一套代码接全部」,Chat Completions 就是事实标准。 baseURL一张牌打天下:SDK 只要把请求发到「OpenAI 风格的端点」,剩下的鉴权、消息格式大家都长得一样。端点从环境变量读,换服务商 = 改.env,不改代码。messages数组第一次登场:注意,哪怕是「一句话」,SDK 也要求你给它一个消息数组——这里已经埋了下一条线索。
作为一个勤于思考的小同学,你可能会嘀咕:这 SDK 是不是藏了太多魔法?别急,等第 03 章讲到流式、第 04 章讲到 Provider 抽象,这些魔法会一块块被我们自己拆掉。
六、实现代码
src/index.ts 全量如下:
import OpenAI from "openai";

function getApiKey(): string {
  const apiKey = process.env.OPENAI_API_KEY;
  if (!apiKey) {
    console.error("缺少 OPENAI_API_KEY:请复制 .env.example 为 .env 后填入真实 Key");
    process.exit(1);
  }
  return apiKey;
}

const client = new OpenAI({
  apiKey: getApiKey(),
  baseURL: process.env.OPENAI_BASE_URL,
});

async function main() {
  const input = process.argv[2] ?? "用一句话介绍你自己";
  const model = process.env.OPENAI_MODEL ?? "gpt-4o-mini";

  console.log("Input :", input);

  const startedAt = Date.now();
  const completion = await client.chat.completions.create({
    model,
    messages: [
      { role: "system", content: "你是一个简洁、直接的中文助手。" },
      { role: "user", content: input },
    ],
  });
  const elapsedMs = Date.now() - startedAt;

  const output = completion.choices[0]?.message.content ?? "";
  console.log("Output:", output.trim());

  const usage = completion.usage;
  if (usage) {
    console.log(`Model : ${model} · ${elapsedMs}ms · ${usage.prompt_tokens} in / ${usage.completion_tokens} out`);
  } else {
    console.log(`Model : ${model} · ${elapsedMs}ms`);
  }
}

main().catch((error) => {
  console.error("调用失败:", error instanceof Error ? error.message : String(error));
  process.exit(1);
});
几个值得注意的设计点:
getApiKey()先守门:没有 Key 就给出明确提示并exit(1),绝不带病发请求;baseURL可配置:process.env.OPENAI_BASE_URL不填就是 OpenAI 官方,填了就接兼容端点——换服务商不改代码;process.argv[2]让输入可替换:pnpm dev -- "你的问题"就能换 Input,不用改代码;OPENAI_MODEL可覆盖:模型名也是环境变量约定的一部分,缺省gpt-4o-mini;- 耗时 + token 用量:这是「可观察性」的第一次露面,后面会变成大事。
.env.example 相应更新(模板里已带各服务商的端点注释):
# OpenAI 接口风格服务商的密钥
OPENAI_API_KEY=

# 可选:OpenAI 兼容端点,缺省为 https://api.openai.com/v1
# OPENAI_BASE_URL=https://api.deepseek.com/v1

# 可选:模型名,缺省为 gpt-4o-mini
# OPENAI_MODEL=deepseek-chat
七、运行 Demo
接下来进入正题,正确的使用姿势如下,三步走:
pnpm install               # 首次:安装依赖(含 openai)
# 复制 .env.example 为 .env 并填入真实 OPENAI_API_KEY
pnpm dev                   # 用默认问题调用一次
pnpm dev -- "讲个笑话" # 换一个问题再调一次切换服务商,改 .env 即可,代码一行不动:
| 服务商 | OPENAI_BASE_URL | OPENAI_MODEL 示例 |
|---|---|---|
| OpenAI | 不填(默认) | gpt-4o-mini |
| DeepSeek | https://api.deepseek.com/v1 | deepseek-chat |
| 通义千问 | https://dashscope.aliyuncs.com/compatible-mode/v1 | qwen-plus |
| Moonshot | https://api.moonshot.cn/v1 | moonshot-v1-8k |
| 硅基流动 | https://api.siliconflow.cn/v1 | deepseek-ai/DeepSeek-V4-Flash |
| 本地 Ollama | http://localhost:11434/v1 | qwen2.5:7b |
没配 Key 时,程序不会静默失败,而是干脆利落地提示:
缺少 OPENAI_API_KEY:请复制 .env.example 为 .env 后填入真实 Key网络受限时(比如需要代理才能访问 OpenAI),SDK 会尊重标准的 HTTPS_PROXY 环境变量,Node 22+ 默认即生效:
$env:HTTPS_PROXY = "http://127.0.0.1:端口"   # PowerShell
# 或
export HTTPS_PROXY=http://127.0.0.1:端口    # bash
看到 Input / Output / Model 三行都正常打印,就说明第一次模型调用打通了。
八、新架构解决了什么?
- 真的调通了模型:从「管道没水」到「有水在流」,这是质的区别;
- 换服务商不改代码:Endpoint 和模型名都收敛进
.env,OpenAI 兼容生态随便换; - 验证了环境变量约定不是摆设:00 章设计的
.env约定在这里第一次派上真实用场; - 可观察:耗时、token 用量、错误信息,全部显式可见,不是黑盒;
- 为后续章节提供了实验对象:后面所有的抽象(消息、流式、Provider)都要拿这「一次调用」当靶子来改造。
九、它又引入了什么问题?
这一章有多爽,暴露的问题就有多明显:
messages数组还是「裸」的:它只是 SDK 的魔法字符串数组,我们既没有自己的类型,也不知道它到底有哪些角色、能装什么;- 没有流式:
await等全部完成才返回,体验上是「憋一口气,然后全吐出来」,既慢又没反馈; - 没有错误模型:网络断、限流、Key 失效、内容被拒……统统挤在一个
error.message里,没法精细处理; - 配置耦合还是太松:Key、Endpoint、模型名靠三个环境变量硬撑着,没有任何代码层面的抽象保证「换 Provider 不碰逻辑」。
最大的矛盾:输入只是「一句话」,输出只是「一段文」,而 SDK 已经悄悄在背后要求我们使用「消息数组」——我们却还没有自己的消息类型。
十、下一章
02 · Messages 是什么——《Hello Harness 02:对话不再是字符串》。既然 SDK 逼着我们用了 messages 数组,那我们就正式把它接过来:
type Message =
  | SystemMessage
  | UserMessage
  | AssistantMessage;
到那时,Input 就不再是孤零零的一句话,而是一段可以被多轮对话、可以被记住上下文的消息序列。模型调用,才算真正迈入「对话」的门槛。
那么问题来了——我们自己的 Message 类型到底该长什么样?system / user / assistant 这几个角色,和 SDK 的 messages 数组又该怎么一一对应?多轮对话时,历史消息该存在哪、怎么一点点攒起来?
以上这些问题,留在下一篇逐一介绍。好了,本章就到这里。如果第一次跑通模型调用让你觉得「这玩意儿好像也没那么玄乎」,那我们的目的就达到了。欢迎点赞、关注公众号「一灰灰Blog」,咱们下一章接着上菜 😊
微信公众号: 一灰灰Blog